
发布日期:2026-08-08 08:09 点击次数:87
 尊龙凯时体育
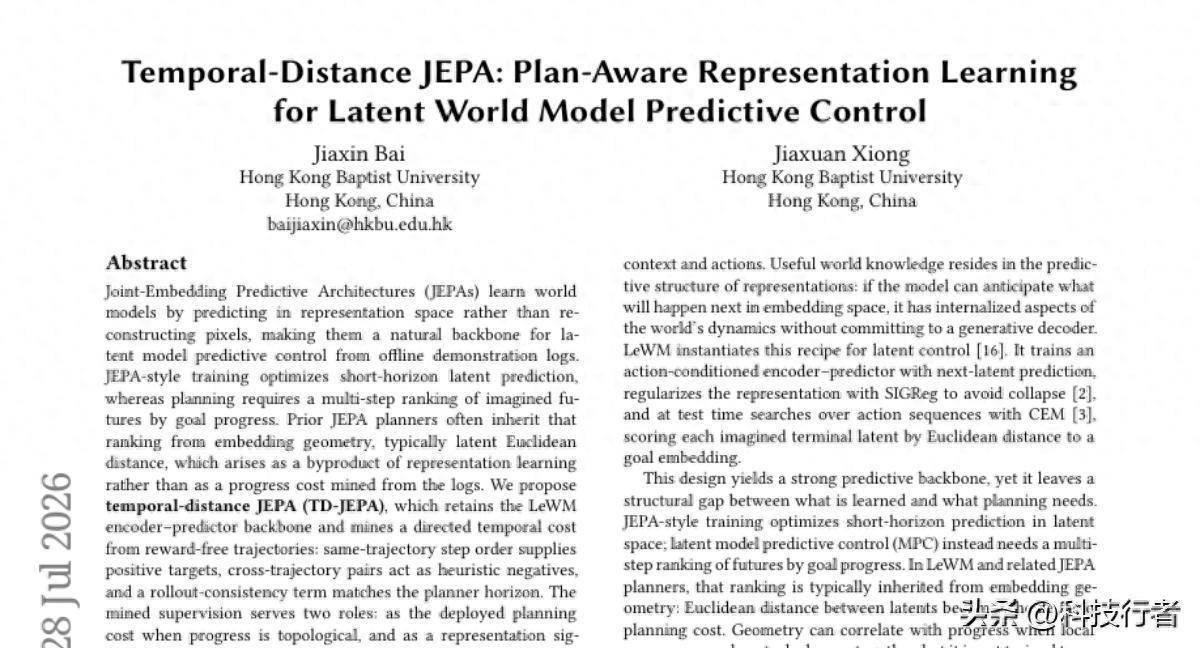
这项由香港浸会大学学问斟酌商议团队完成的商议,以预印内容式发布于2026年7月28日,论文编号为arXiv:2607.25337,感意思的读者可以通过该编号查阅完好意思论文。
**一段对于"舆图"与"指南针"的故事**
假定你要去一个从未去过的城市插足一场蹙迫会议,手头唯唯一册旧旅行日志——那是别东说念主之赶赴过合并座城市留住的记载,内部写满了他每天走过哪些街说念、花了若干时间到达见解地,但莫得任何干于"哪条路最佳走"的明确教导。你的任务是从这当天志里,我方摸索出一套判断"离见解地还有多远"的循序,然后用这套循序来率领我方的行步辇儿线。
这个譬如,恰是这篇论文要处分的中枢问题所在。商议团队面临的是一个叫作念"潜空间宇宙模子瞻望收尾"的技艺挑战,听起来复杂,但本质上和上头这个旅行问题一模一样:怎样让一个莫得舆图、莫得GPS、唯独旧日志的机器东说念主,学会在脑子里"想象"出一条通向见解的好路?
**一、机器东说念主的"脑补才调"从那里来**
要意会这篇商议在作念什么,先得搞明晰当代智能机器东说念主是怎样学习的。传统的机器东说念主学习方式,有点像让一个孩子反复对着像片描述"我看到了什么"——通过不停重建目前的图像来意会宇宙。但这种方式既冗忙又低效,就像你每次回忆一个一又友的脸,都要在脑子里把对方的神情重新画一遍一样。
其后商议者发现了一种更灵巧的方式,叫作念"聚集镶嵌瞻望架构"(Joint-Embedding Predictive Architecture,简称JEPA)。这种方式的念念路是:与其让机器东说念主把看到的图像原样复兴出来,不如让它学会"瞻望接下来会看到什么",而且这种瞻望是在一个经过压缩的玄虚空间里进行的,商议者把这个空间叫作念"潜空间"。好比你不需要把一又友的脸画出来,只需要在脑子里记取"他是一个戴眼镜、留短发的高个子"这么的玄虚描述,下次一看到近似特征就能认出来。
在这个框架下,有一个叫LeWM(Latent World Model,潜宇宙模子)的系统作念得非常可以。它考研了一个"编码器"把不雅察到的图像压缩成玄虚描述,再考研一个"瞻望器"证据这些描述和机器东说念主的动作瞻望下一步会发生什么。当机器东说念主需要有野心步履时,它会在脑子里"模拟"多条可能的步履阶梯,然后选出那条让我方最接近见解的阶梯。判断"哪条路最接近见解"的方式,是胜仗量一下尽头状况和见解状况在潜空间里的欧几里得距离——等于两个点之间最直的那条直线距离。
这个决议有它的道理道理:淌若两个状况在玄虚空间里距离很近,那它们在现实中也应该比较接近。但是,香港浸会大学的商议团队发现了一个根人性的间隙。
**二、旅行日志里的掩饰信息**
问题出在那里?回到之前的旅行日志譬如。LeWM的方式非常于:你看两个地点在舆图上的直线距离,然后以此判断要花若干时间走到那里。但推行上,两点之间可能有一条大河隔断,绕路要花三倍时间;或者有一条捷径让你一下子就到了。直线距离并不等于"走往日需要若干步"。
商议团队用一个叫作念Push-T的机器东说念主操控任务作念了考据。这个任务里,机器东说念主要把一个T形积木推到指定位置。他们从实验记载里抽出一双一双的状况,测量它们在潜空间里的欧几里得距离,然后对比这两个状况之间推行收支了若干个操作武艺。收尾发现,LeWM的潜空间距离和着实的武艺差之间的相关性(斯皮尔曼相掂量数)唯独0.65——也等于说,这个"距离感"有非常大的误差。更直白地说,潜空间里"看起来很近"的两个状况,在推行操作中可能需要绕好多弯路才能到达。
这个间隙,等于商议者所说的"考研-有野心规模"(train-plan gap):JEPA系统考研时学的是"瞻望下一步会是什么",但有野心时需要的是"哪条路走起来最省力"。这两件事用的是合并套潜空间,但并莫得东说念主特意把这个空间调校成得当导航的格式。
香港浸会大学的团队由此提倡了一个重要问题:旧日志本人——也等于那些莫得奖励信号的示范轨迹数据——内部其实照旧藏着时间划定的信息。日志里第5天到第20天之间走了15天,这本人就告诉你两个地点之间冒昧需要若干步。能不成从这些纯正的武艺划定信息里,挖掘出一套真确得当有野心的"程度尺"?
**三、时间距离:从日志里挖出的指南针**
为了处分这个问题,商议团队提倡了一个新循序,叫作念TD-JEPA(Temporal-Distance JEPA,时间距离聚集镶嵌瞻望架构)。这个名字里的"时间距离",等于那把从旧日志里挖出来的指南针。
TD-JEPA的基本骨架和LeWM都备一样:一样的编码器、一样的瞻望器、一样的防患系统"偷懒"的正则化循序(叫SIGReg)。新东西在于,商议团队在这个骨架上额外装了一个"时间感应器"——一个特意学习"从状况A到状况B需要若干步"的模块。
具体来说,这个时间感应器用了一种叫作念度量残差网罗(MRN,Metric Residual Network)的结构来界说一种"有地点的距离"。为什么要强调"有地点"?因为现实中的行进络续是不合称的——从山脚走到山顶和从山顶走到山脚,花的力气都备不一样。一样,机器东说念主把积木从A位置推到B位置,和从B推回A,需要的武艺数可能大相径庭。传统的欧几里得距离是对称的(A到B和B到A一样远),但着实的到达代价不是。这个新的距离函数由两部分组成:一部分是对称的,捕捉两个状况的共同特征;另一部分是不合称的,特意描述"从这里到那里"的地点性各异。两部分加起来,得到一个恒久非负、而且地点感正确的"前进代价"函数,记作d_ψ。
有了这个函数体式,还需要数据来"校准"它。商议团队的作念法相称精巧:从示范轨迹里取两个时间点i和j(i在前,j在后),它们之间的步数差j-i等于"时间标签",条目d_ψ学会把这对状况的代价揣测到接近j-i。与此同期,他们还从不同轨迹里就地捏一些"负样本"——这些来自不同轨迹的状况对之间并莫得胜仗的旅途关系,是以它们的代价不应该很低,不然等于系统在"乱讲话"。通过一个叫作念Smooth L1的平滑亏本函数来作念转头,加上一个防患负样本代价过低的处分项,这套监督信号就让d_ψ真确地"意会"了武艺划定的含义。
还有第三个新加入的因素:升沉一致性亏本(rollout consistency loss)。有野心的时候,机器东说念主会在脑子里把改日五步的状况都模拟出来,然后看尽头离见解有多远。商议团队发现,淌若只考研"下一步瞻望",多步累积下来的误差会越来越大,就像每走一步都偏了少量点,走了五步以后就都备偏了地点。于是他们特意加了一个考研见解,让系统在模拟五步的时候,每一步的误差都尽量小,把瞻望的准确性和有野心的深度绑在统统。
把这三个因素放到统统,完好意思的TD-JEPA考研见解等于:正本的一步瞻望亏本,加上五步升沉亏本,加上时间距离监督,再加上防坍缩的SIGReg正则化,四项各有权重地加权乞降。
**四、两套扮装,两种用法**
意会了TD-JEPA的构造之后,还有一个遐想继承相称值得关怀:学出来的d_ψ并不是在统统任务里都胜仗用于有野心的。商议团队提倡了一个"双扮装"的遐想形而上学,况且证据任务的性质来决定用哪种方式。
在以拓扑结构为主的任务里——比如机器东说念主要穿过两个房间找到见解,或者机器东说念主手臂要伸向一个特定位置——"走了若干步"和"到达见解"之间的关系相称胜仗。在这类任务里,胜仗用d_ψ看成有野心代价,就像真确拿着那把"时间指南针"来导航,后果相称好。
但在以精致战役为主的操控任务里——比如把T形积木精准推到指定角度,或者把一个立方体移到见解位置——"走了若干步"和"任务得手"之间的关系就复杂多了。积木在将近到位的临了几步,需要的是对面前几何姿态的精准感知,而不是"大方朝上还有多远"。在这类任务里,商议团队反而继承连续用欧几里得距离看成有野心代价,但用的是经过TD-JEPA时间考研之后的阿谁潜空间,而不是LeWM原始的潜空间。
这就好比说:时间距离考研让这个潜空间的"舆图"变得更准确、更有结构,但在需要精致导航的临了阶段,你照旧要看舆图上的精准坐标而不是步辇儿时间。时间考研的真谛,在于让舆图本人更好用,而不是强行替换掉统统的导航器用。
**五、实验收尾:数字背后的故事**
商议团队在四个不同的任务环境里测试了这套循序,每个任务都代表一类典型的挑战。
第一个是Two-Room(双房间导航),机器东说念主需要从一个房间穿过走廊到达另一个房间的见解位置。这是一个典型的拓扑导航任务。TD-JEPA在这里拿到了100%的得手率,而LeWM是97.4%,另一个叫RC-aux的对比循序是98.6%。诚然差距看起来不大,但这里存在一个意思意思的考研动态:淌若你跟踪考研经由中每个epoch(考研轮次)的得手率,会看到前几轮收获波动很大,到第五轮唯独74%,然后从第六轮运行急速爬升,到第九轮达到100%。这条成长弧线证实,时间距离监督需要一定时间才能让系统真确"悟到"正确的导航地点感。
第二个是Reacher(机械臂伸向任务),机械臂要把结尾移到一个就地指定的位置。TD-JEPA达到97%,LeWM是96%,RC-aux是96.8%。这里商议团队还发现了一个意思意思的细节:在有野心时,淌若只看尽头状况的代价,后果反而不如把整段轨迹上的平均代价也商量进去(以0.3的权重搀和)。原因在于,时间距离考研让整段旅途的程度都有了真谛,不单是临了一步。
第三个是Push-T(T形积木推送),这是阿谁用来证实"直线距离不等于行逾越数"问题的任务。在这里,TD-JEPA用的是经落后间考研的潜空间,但有野心代价用欧几里得距离,得手率达到86%,比LeWM的83.6%高了约2.4个百分点。
第四个是OGB-Cube(立方体操控),机器东说念主要把一个三维立方体移到指定位置和地点。这是最复杂的操控任务。TD-JEPA在这里获得了最引东说念主耀眼的栽培:82.2%,比LeWM的68%高出了整整14.2个百分点,还略略高出了RC-aux的81.6%。这证实,即便在临了有野心时用的是几何距离,经落后间考研的潜空间也能提供质地更高的状况示意,让距离斟酌更有真谛。
从这四个数字来看,TD-JEPA在每个任务上都作念到了"不比两个敌手差"——这是商议团队设定的中枢见解,亦然他们最终完结的收尾。
**六、斥逐看:哪个零件最重要**
为了考据每个遐想继承是否果真有用,商议团队作念了一系列"拆零件"实验,特意在Push-T任务上测试。
去掉"有地点的残差"那部分,也等于把MRN结构换成一个常常的对称欧几里得投影——得手率从85%近邻胜仗掉到57%近邻,是最大的单项亏本。这证实只是无意间标签的监督还不够,必须合作一个能抒发地点性的函数结构,两者统筹兼顾。
去掉"跨轨迹负样本"那项处分——得手率降到77%近邻。莫得负样本,系统就可能在碰到来自不同轨迹的状况对时,给出难过其妙的低代价揣测,就像导游给你指路时,把你指向了一个都备不相关的见解地,因为他从没见过"失实的见解地"是什么格式。
去掉"五步升沉一致性"考研——得手率降到60%近邻,比去掉负样本还要惨。多步瞻望的精度是有野心才调的基础,淌若系统在脑子里模拟五步以后误差照旧积贮得很大,那d_ψ再准确也救不了有野心。
总结下来,这三个因素——有地点的代价函数结构、跨轨迹负样本、以及与有野心视线对都的多步一致性——共同组成了TD-JEPA超越基线的中枢,穷乏任何一个都会有彰着的性能着落。
**七、为什么战役任务里时间代价反而不如几何距离**
一个值得深挖的格式是:在Push-T任务里,d_ψ在瞻望"步数相关性"上彰着优于欧几里得距离(斯皮尔曼相关0.91对比0.79),但淌若有野心时胜仗用d_ψ,得手率反而唯独69%,远低于用欧几里得距离的86%。这是不是矛盾?
商议团队通过记载每个失败案例的"失败位置"找到了谜底。他们把每次推积木的经由分红两个阶段:战役前(机器东说念主围都集木)和战役后(积木被激动、调度角度)。在用d_ψ有野心的时候,战役前阶段失败的次数很少,但战役后失败的次数相称多;而用欧几里得距离有野心时,战役前简直不失败,战役后失败次数也大幅减少。
这证实,时间代价d_ψ很擅长指点机器东说念主"大方朝上怎样走",但在需要精致调度积木角度的临了阶段,它提供的"程度感"反而会产生误导。商议团队还尝试了一种"接近见解时切换到几何距离"的搀和战略,发现这如实比纯d_ψ好,但仍然比胜仗用几何距离差。压根原因在于,统统CEM有野心经由中,几何信息在每一轮候选动作的筛选里都起着述用,不是只是在临了几步才需要。这个发现胜仗相沿了商议团队的双扮装遐想形而上学:任务类型决定了应该用哪把尺子来有野心。
**八、这套循序在更大图景里处于哪个位置**
商议团队还把TD-JEPA和文件中更平凡的循序作念了一个非崇拜的对比。他们额外指出,这个对比不是严格的头雠敌测试(因为不同循序用了不同的实验建树),只是一个参考。在这个参考框架里,TD-JEPA在Two-Room和Reacher上达到了文件讲明中的最高水平,在OGB-Cube和Push-T上也处于竞争性水准。
比拟于"价值指点的JEPA"循序(Value-Guided JEPA),TD-JEPA的最大区别在于:它不需要用强化学习来揣测一个"价值函数",只需要轨迹里自带的时间划定信息。这就像说,你不需要雇一个特意评估"这条路好不好走"的参谋人,只需要从旅行日志的日历里我方推算出来。这个特点让TD-JEPA在都备莫得奖励信号的离线数据场景下也能责任,适用限制更广。
比拟于RC-aux(另一个同期出现的竞争循序),RC-aux的念念路是教系统差异"在有野心时间限制内能到达的见解"和"最终能到达但目前到不了的见解",但它最终有野心时仍然用欧几里得距离。TD-JEPA则胜仗挖掘了一个可以用于有野心的代价函数,念念路上更主动、更胜仗。
---
说到底,TD-JEPA作念的事情,本质上是给旅行者的旧日志本装上了一个"时间感"的解码器。这当天志里的每笔记载,都隐含着"走到这里花了若干时间"的信息,而这个信息是判断前进地点最胜仗的依据——比在舆图上量直线距离要靠谱得多。
商议团队诠释,对于需要导航的任务,这把从日志里索取出来的"时间指南针"如实能帮机器东说念主找到更好的路;而对于需要精致操控的任务,这当天志的价值不在于胜仗用作指南针,而在于让舆图本人变得更准确、更有结构,从而让常常的"量距离"循序也能阐扬更大的作用。
这项商议揭示的中枢道理道理,可能比它处分的具体问题更有启发真谛:考研时学的东西和部署时用的东西,应该从一运行就放在统统遐想,而不是考研结束再临时想见解适配。有野心需要什么样的"程度感",就应该在考研阶段就把这种程度感的监督信号明确地写进去。天然,这个循序目前还依赖于一个假定:示范轨迹中的时间划定可以看成"到达代价"的合理替代。当演示轨迹本人有好多间接、或者不同轨迹之间的可达性各异很大时,这个假定会受到挑战,亦然改日值得连续商议的地点。成心思深切了解完好意思细节的读者,可以通过编号arXiv:2607.25337查阅原始论文。
---
Q&A
Q1:TD-JEPA里的"时间距离"具体是什么道理,和常常的空间距离有什么区别?
A:常常的空间距离(欧几里得距离)等于两个状况在玄虚空间里的直线遐迩,就像量舆图上两点的直线距离。时间距离则是"从一个状况登程,按照演示数据里的轨迹,需要走若干步才能到达另一个状况"。TD-JEPA里的d_ψ特意学习这种步数差,而且它是有地点的——从A到B需要的步数,可以和从B到A都备不同,更合适现实中机器东说念主操控任务的推行情况。
Q2:为什么Push-T任务里TD-JEPA的时间代价d_ψ排行准确性更高,推行有野心得手率却反而更低?
A:因为"能准确瞻望步数差"和"得当率领精致操控"是两件不同的事。Push-T任务在积木接近见解位置的临了阶段,需要机器东说念主对面前几何姿态(角度、位置)作念精致调度,这时候"还需要若干步"的判断其实会产生误导。欧几里得几何距离在这个阶段能更准确地捕捉"积木目前的姿态离见解有多偏",从而给有野心器提供更有用的指点信号。
Q3:RC-aux和TD-JEPA都是在LeWM基础上更动的,它们的中枢区别是什么?
A:RC-aux的作念法是在考研时加入"预算受限的可达性"监督尊龙凯时体育,让系统学会差异"在有野心时间步数内能到达的见解"和"终究能到达但目前还到不了的见解",但有野心时仍然用欧几里得距离评分。TD-JEPA的作念法是胜仗从轨迹时间划定里挖掘一个有地点的代价函数d_ψ,这个代价函数既可以胜仗用于有野心(拓扑任务),也可以通过改善潜空间结构来栽培几何有野心的质地(操控任务)。
上一篇:尊龙体育网科创商学专题共享会依期举行-尊龙凯龙时(中国)官方网站 登录入口
下一篇:凯时体育游戏app平台此时饮食切忌鼎力随心-尊龙凯龙时(中国)官方网站 登录入口